# s16: Workflow Runtime — 把步骤写进代码
[English](README.md) · [中文](README.zh.md) · [日本語](README.ja.md)
[s15](../s15_integrated_harness/) → `s16` → [s17](../s17_goal_loop/)
> *计划不必只活在对话里。* 先后顺序交给脚本,每一步的判断留给模型。
>
> **Harness 层**: 编排 — 在单个 Agent 循环之上,再运行一套多 Agent 脚本。
## 问题
一路学到这里,你已经见过模型如何在循环里读文件、改代码、查看报错。
可有些事情,顺序其实一开始就清楚:先分几个角度看看,再请另一位核对,最后汇总。若这些步骤只靠聊天记着,时间一长就容易乱——做到一半以为结束了;自己复查时又容易放过问题;上下文压缩几轮之后,原先那句「请别改动 X」也可能渐渐淡掉。
对话很适合探索。它不太擅长稳住并行、固定结果的形状,也不太擅长中断之后从同一个地方接着做。这时你需要的,往往不是一个更会聊天的模型,而是一份**写下来的步骤**。
## 解决方案
```text
对话 ──► Workflow(...) ──► 结果回来
│
▼
脚本:agent / pipeline / parallel
│
▼
变量 + journal(中间结果放这里)
```
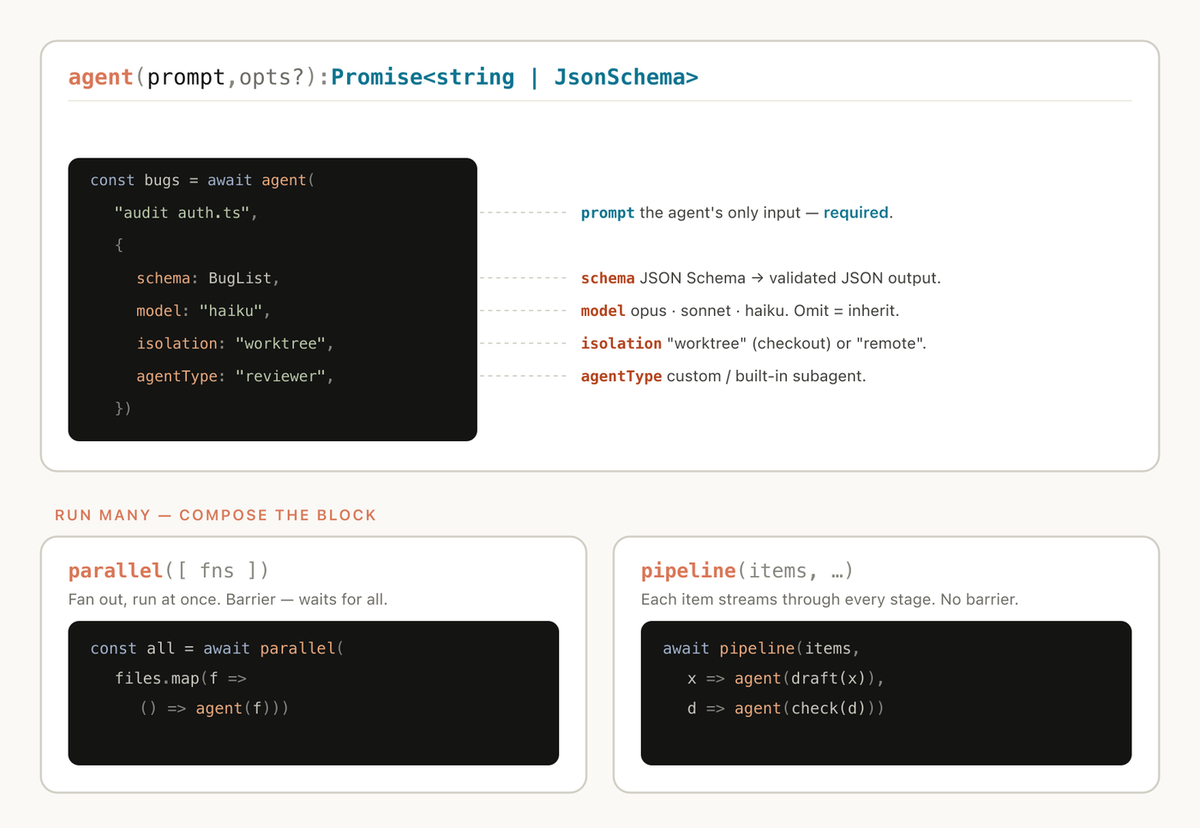
子 Agent 仍然负责思考。**脚本**负责循环、分发与合并。中间结果放进变量和 journal,不必再挤回主对话。
可以记一句:**让结构来保管步骤,让模型来做判断。**
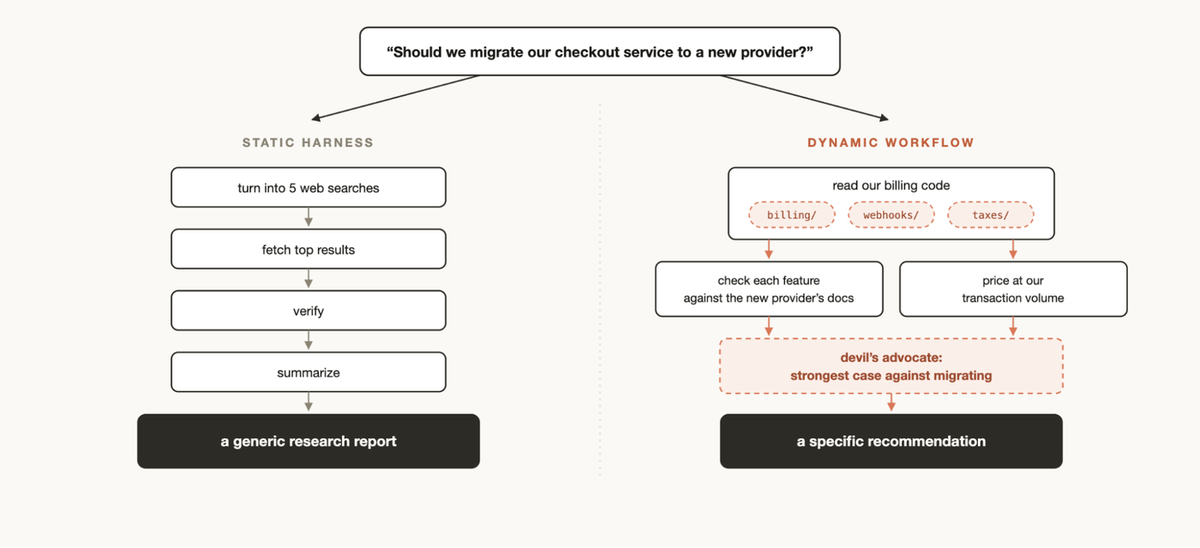
*左:事先写好的通用流程。右:为这一次任务量身写下的编排。*
在 Claude Code 里,常见有两种用法。**动态**:模型为这次任务写一段 JavaScript(`script` / `scriptPath`)。**已保存**:跑顺了的脚本留在仓库里,用 `name` 和 `args` 再次唤起。此外还有用 SDK 事先写好的静态编排。本章是一个 **Python 教学运行时**,不内嵌 JS 引擎:想法与产品对齐,演示走「已保存」这一路。产品里模型本来就可以提交脚本,我们只是在这里用更易读的 Python 来讲清楚。
## 工作原理
**1. 先认识三个词**
```text
agent 一位帮手,完成一件事(可带 schema,得到便于传递的 JSON)
pipeline 每一项各自走完各阶段(默认如此,不必互相等待)
parallel 等齐所有结果再继续(屏障,偶尔使用)
```
某一步不顺利时,不必让整次运行停住:`parallel` 里出问题的那一格会变成 `null`;`pipeline` 则跳过那一项。合并之前,先把空位滤掉即可。
**2. 若要接着跑,用小本记下进度**
每调用一次 `agent()`,journal 就按**调用顺序**记一笔。再次运行时,从前往后核对:尚未改动的前缀可以直接复用;遇到第一处变化,之后的步骤再重新执行。真实的 JS 运行时不宜使用 `Date.now()` / `Math.random()`,否则记录很难对齐。教学脚本也尽量写成确定的。
```text
journal [A] [B] [C] [D]
续跑 复用 复用 ✂ 重跑
```
**3. 用一个例子串起来**
`review-changes` 并不只是一种固定招式。它先把工作拆开,再请另一路核对:多个维度各自走 `pipeline(audit, verify)`,在验证阶段用 `parallel` 并行检查,最后只留下仍然成立的发现。
```text
correctness ── 审阅 ── 核对 ──┐
security ── 审阅 ── 核对 ──┤── confirmed
performance ── 审阅 ── 核对 ──┤
style ── 审阅 ── 核对 ──┘
```
```python
# 摘自 code.py,先看形状
async def sample_workflow(ctx, args):
ctx.phase("Review")
results = await ctx.pipeline(DIMENSIONS, audit, verify)
confirmed = [f for r in results if r for f in r["confirmed"]]
return {"confirmed": confirmed}
```
这样安排之后,步骤不容易半途收束,作者也不必兼任唯一的检查者,流程也不必随着聊天一轮轮改写。
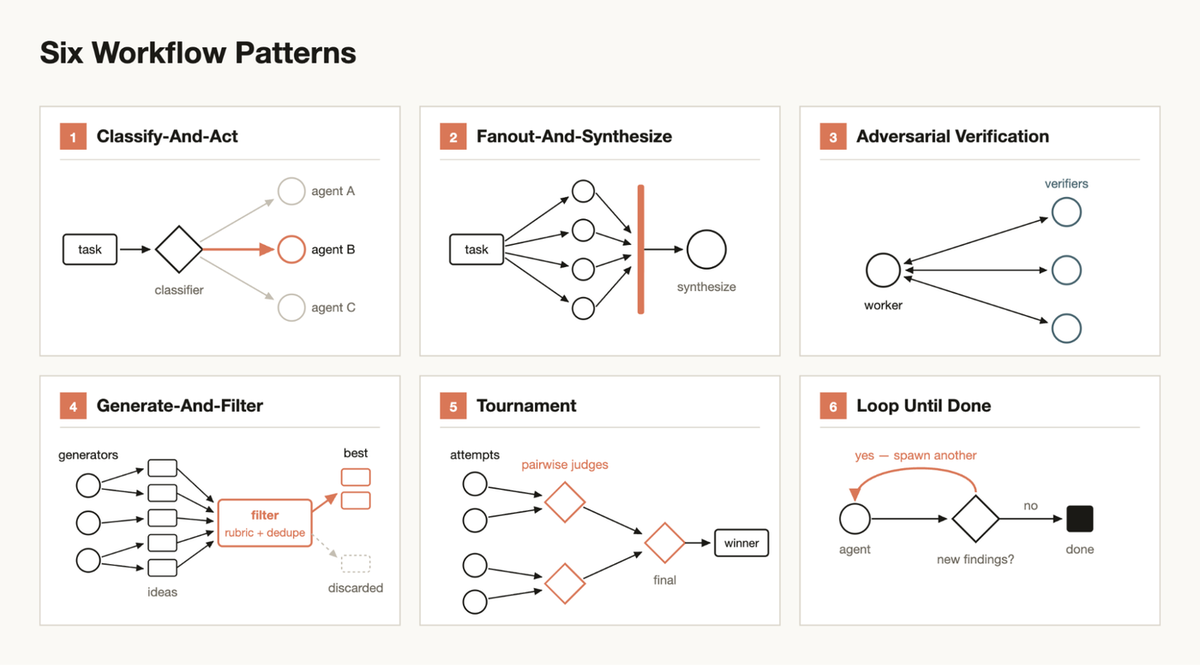
六种常见形状
| 名称 | 含义 | 如何组合 |
|------|------|----------|
| Classify-And-Act | 先分类,再交给合适的帮手 | `agent` → 分支 → `agent` |
| Fanout-And-Synthesize | 分头进行,再汇总 | `pipeline` / `parallel` → 汇总 |
| Adversarial Verification | 请另一路来核对,而不是只听自己 | 产出 → `parallel(verify)` → 过滤 |
| Generate-And-Filter | 先多准备几份,再筛选 | `parallel` 生成 → 过滤 |
| Tournament | 两两比较,留下更好的 | 裁判 `agent` |
| Loop Until Done | 仍有新发现就继续 | `while` + 停止条件 + `budget` |
`review-changes` 大约是 Fanout 与 Adversarial 的组合。做调研时,也常再叠上:分发 → 过滤 → 核对 → 汇总。
动态、已保存、静态,以及官方示意
```python
# 教学示意
Workflow({ "name": "review-changes", "args": { "changes": "..." } })
# Claude Code 还接受:script | scriptPath | resumeFromRunId
```
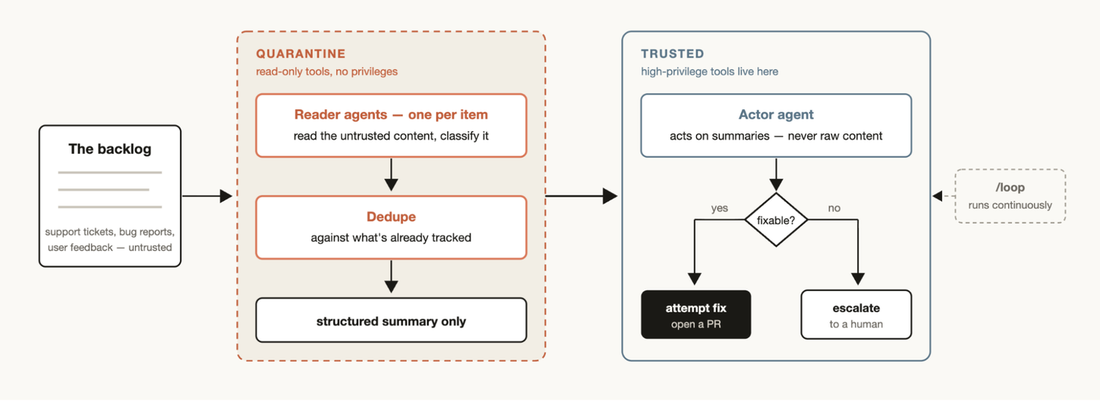
遇到不可信输入时,把读取与行动分开
负责阅读工单的 Agent,不宜同时握有发起变更的权限。可以让一侧只读、整理成摘要;另一侧只根据摘要行动。
```text
待办 → [阅读区: 读取 / 去重 / 摘要] → [行动区: 执行]
```
不妨问一句:计划由谁保管?s06 是一次性委托;s13 是长期协作的队友;s15 在单次循环的对话里决定下一步;**s16 把步骤写进脚本,把进度记在 journal**;s17 则关心整件事是否已经完成。
日常改几个文件,s15 或一次 s06 往往就够。Workflow 会多花一些 token,也需要一点协调——**当步骤需要比单次对话活得更久**,再请它来帮忙。
## 试一试
```bash
python s16_workflow_runtime/code.py demo
python s16_workflow_runtime/code.py resume
```
第一次运行,可以留意从 Review 走到 Verify。同一 run 再执行一次,多数步骤应显示为 `cached`(理想情况是 `agents=0 tokens=0`)。若想放进上一章的完整程序,不加参数直接运行 `code.py` 即可。
s15 仍是那个循环;这里只是多了一个 `Workflow` 工具。[s17](../s17_goal_loop/) 会接着问:是否可以停下了?