# s16: Workflow Runtime — 把步骤写进代码
[English](README.md) · [中文](README.zh.md) · [日本語](README.ja.md)
[s15](../s15_integrated_harness/) → `s16` → [s17](../s17_goal_loop/)
> *别把计划只留在聊天里。* 谁先谁后由脚本定,每一步怎么判断交给模型。
>
> **Harness 层**: 编排 — 在单个 Agent 循环上面,再跑一套多 Agent 脚本。
## 问题
到这一章,你已经会让模型在循环里读文件、改代码、看报错了。
可有些活,你其实早就想好了顺序:先按几个角度审一遍,再找人挑刺,最后汇总。顺序如果只记在对话里,模型很容易做到一半就喊「做完了」;让它自己评自己,分数又往往偏高;上下文压了几轮之后,「别动 X」这种约束也可能悄悄不见。
聊天记不住并行,也扛不住中途崩掉再接着跑。你缺的不是一个更会聊天的模型,而是一份**写下来的步骤**。
## 解决方案
```text
你的对话 ──► Workflow(...) ──► 一条结果回来
│
▼
脚本:agent / pipeline / parallel
│
▼
变量 + journal(中间结果放这里,别塞回对话)
```
子 Agent 还是负责想。**脚本**负责循环、分发、合并。中间结果放进变量和 journal,不进主对话。
一句话:**把「怎么排步骤」从临场发挥,变成写死的结构。**
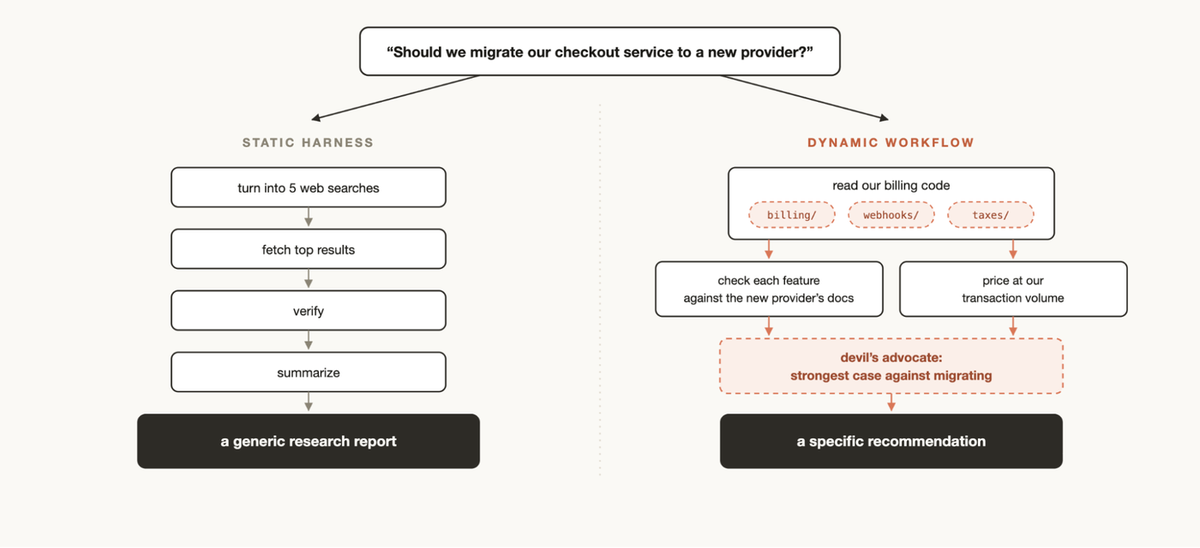
*左边:事先写好的通用流水线。右边:为这次任务临时裁出来的编排。*
在 Claude Code 里,入口大致有两种。**动态**:模型为这次任务写一段 JS(`script` / `scriptPath`)。**已保存**:跑通了的脚本放进仓库,用 `name` + `args` 再调。外面还有一种事先用 SDK 写死的静态编排。本章是 **Python 教学版运行时**,不嵌 JS 引擎:想法对齐,演示走「已保存」这条路。产品里模型本来就能交脚本,我们只是不在这里跑 JS。
## 工作原理
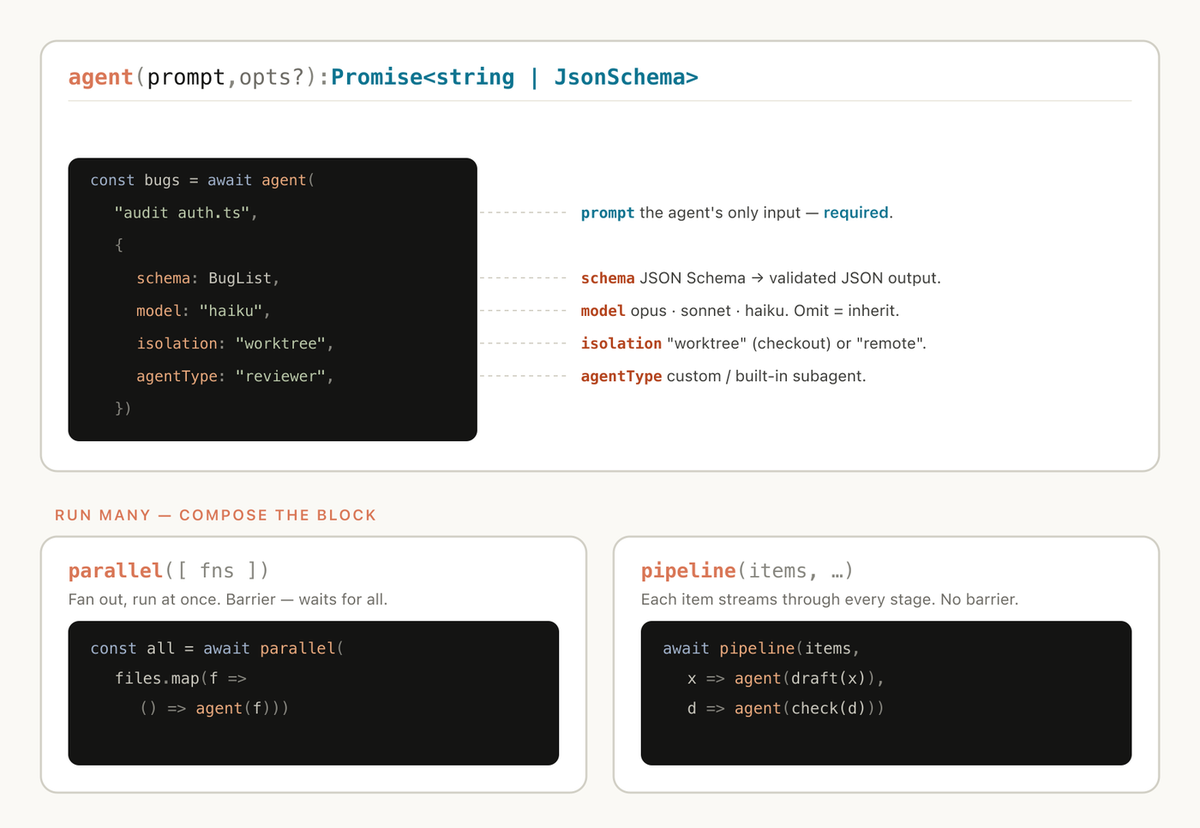
**1. 三个词就够用**
```text
agent 一个帮手,干一件事(可以带 schema,拿到能往下传的 JSON)
pipeline 每个条目自己走完各阶段(默认这样,不用互相等)
parallel 等所有结果到齐再往下(屏障,少用)
```
有人失败了也别整队停工:`parallel` 里失败的那一格变成 `null`;`pipeline` 丢掉那一条。合并前先把空的滤掉。
**2. 想续跑,靠小本子,别靠聊天记录**
每次调用 `agent()`,journal 按**调用顺序**记一笔。续跑时,从头核对:还没改过的前缀直接复用;碰到第一处改动,后面全部重跑。真正的 JS 运行时不许用 `Date.now()` / `Math.random()`,不然本子对不齐。教学脚本也尽量写成确定性的。
```text
journal [A] [B] [C] [D]
续跑 复用 复用 ✂ 重跑
```
**3. 看一个例子:拆开审,再找人对着挑**
`review-changes` 不是单一招式。它是「拆开干」外面,套了一层「别人来挑刺」:几个维度各自 `pipeline(audit, verify)`,验证阶段再用 `parallel` 并行检查,只留下仍然站得住的问题。
```text
correctness ── 审计 ── 验证 ──┐
security ── 审计 ── 验证 ──┤── confirmed
performance ── 审计 ── 验证 ──┤
style ── 审计 ── 验证 ──┘
```
```python
# code.py 节选,看形状就行
async def sample_workflow(ctx, args):
ctx.phase("Review")
results = await ctx.pipeline(DIMENSIONS, audit, verify)
confirmed = [f for r in results if r for f in r["confirmed"]]
return {"confirmed": confirmed}
```
这样一来,队伍没法提早收工,作者也不当自己的裁判,步骤也不会被聊天一轮轮改歪。
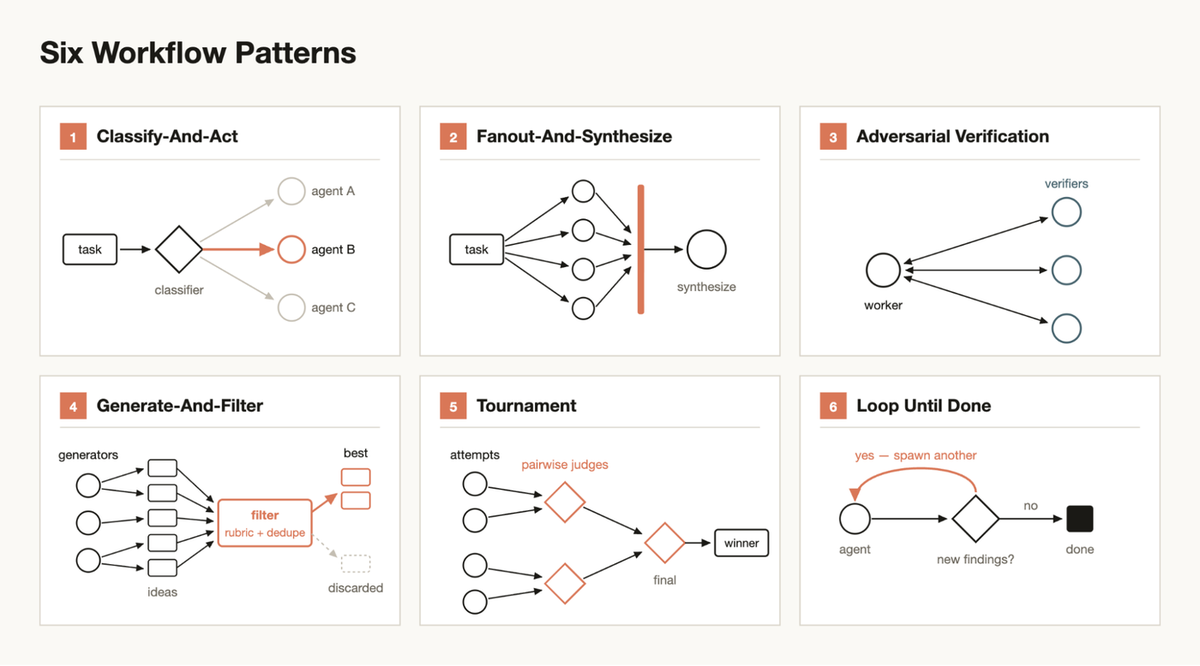
六种常见形状
| 名字 | 人话 | 怎么拼 |
|------|------|--------|
| Classify-And-Act | 先分拣,再交给对的人 | `agent` → 分支 → `agent` |
| Fanout-And-Synthesize | 拆开干,再合并 | `pipeline` / `parallel` → 汇总 |
| Adversarial Verification | 别让自己给自己打分 | 产出 → `parallel(verify)` → 过滤 |
| Generate-And-Filter | 先多写几份,再筛 | `parallel` 生成 → 过滤 |
| Tournament | 两两比,决出更好的 | 裁判 `agent` |
| Loop Until Done | 还有新发现就继续 | `while` + 停止条件 + `budget` |
`review-changes` 大约等于 Fanout + Adversarial。做调研时,常常再叠:分发 → 过滤 → 验证 → 汇总。
动态、已保存、静态,以及官方原语图
```python
# 教学示意
Workflow({ "name": "review-changes", "args": { "changes": "..." } })
# Claude Code 还接受:script | scriptPath | resumeFromRunId
```
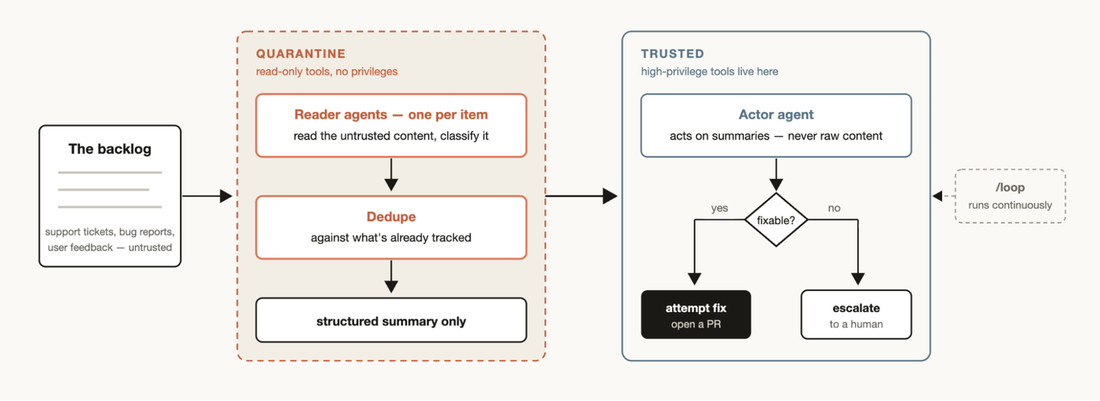
输入不可信时,把读和写隔开
读工单的 Agent,不该同时拿着开 PR 的钥匙。一边只读、整理成摘要;另一边只看摘要再动手。
```text
积压 → [只读区: 读 / 去重 / 摘要] → [可信区: 行动]
```
计划到底谁说了算?s06 是一次性派出去;s13 是长期队友加邮箱;s15 是单循环里聊着决定;**s16 把步骤写进脚本,进度记在 journal**;s17 则在门口问:整件事做完了没有。
平时改几个文件,s15 或一个 s06 多半够了。Workflow 又费 token 又费协调——**只有步骤必须比单次对话活得更久**时,再拿出来用。
## 试一试
```bash
python s16_workflow_runtime/code.py demo
python s16_workflow_runtime/code.py resume
```
第一次跑,看 Review 再到 Verify。同一 run 再跑一次,大多应显示 `cached`(理想情况 `agents=0 tokens=0`)。想挂进上一章的完整程序,不加参数直接跑 `code.py`。
s15 还是那个循环;这里只多了一个 `Workflow` 工具。[s17](../s17_goal_loop/) 问的是另一件事:该停了吗?